Automatisierte Marktanalyse: Flaschenpost Datenpipeline
01 Herausforderung
Im hochkompetitiven e-Grocery-Markt entscheiden tägliche Preisinformationen der Wettbewerber über die eigene Marge – manuell ist das bei tausenden Artikeln nicht leistbar.
02 Ansatz
Reverse Engineering der internen Flaschenpost-Endpunkte, paralleles Abrufen der JSON-Daten je Kategorie, Überführung in ein normalisiertes SQLite-Schema und Auswertung per SQL in einem Flask-Dashboard.
03 Ergebnis
Eine automatisierte Pipeline über 5.000+ Artikel, die Preisentwicklungen, Top-Angebote und Sortimentslücken (Out-of-Stock) frühzeitig sichtbar macht.
In hochkompetitiven E-Commerce-Märkten wie e-Grocery sind tägliche Preisinformationen der Wettbewerber entscheidend für die eigene Marge. Dieses Projekt automatisiert die Datenerhebung von über 5.000 Artikeln, um Preisentwicklungen und Sortimentslücken frühzeitig zu erkennen.
- Artikel
- 5.000+
- automatisiert erfasst
- Datenquelle
- JSON
- interne API statt HTML-Parsing
- Datenmodell
- 3NF
- relationales Schema in SQLite
- Top-Rabatt
- 76,5 %
- höchster Wert im Dashboard-Snapshot
- 01NetzwerkanalyseJSON-Endpunkt je Kategorie identifizierenFirefox DevTools
- 02ExtraktionKategorien parallel abrufen und als JSON sichernThreadPool
- 03DatenmodellStammdaten und Artikeldaten normalisiert speichernSQLite
- 04ProduktbilderBilder aus der DB parallel herunterladenRequests
- 05DashboardFreie SQL-Abfragen mit BildvorschauFlask
1. Datenstrategie: API statt HTML
Anstatt HTML zu parsen, habe ich die internen Schnittstellen der Flaschenpost-App analysiert. Das ermöglicht strukturierten Zugriff auf Stammdaten – ohne die Serverlast eines klassischen Crawlers.
Klassischer HTML-Crawler
- Fragiles Parsing – bricht bei jeder Layout-Änderung
- Lädt komplette Seiten inkl. Markup
- Hohe Serverlast durch viele Seitenaufrufe
Interne JSON-API
- Strukturierte Daten direkt aus der Quelle
- Ein Request pro Kategorie
- Geringe Last, schnell und robust
Überwacht werden Kategorien wie obst-gemuese, kuehlregal/frisch-fertig oder kuehlregal/fleisch-fisch-veggie.
2. Netzwerkanalyse mit Firefox
Mit dem Firefox-Netzwerkanalysetool habe ich untersucht, in welchem Format die Website ihre Daten lädt. Der Schlüssel war die URL https://www.flaschenpost.de/data/[KATEGORIE]/23, die eine JSON-Liste aller Artikel einer Kategorie liefert.
3. Relationales Datenmodell & SQL-Analyse
Für langfristige Preisanalysen werden die JSON-Daten in ein relationales Schema (3. Normalform) überführt:
- product – statische Stammdaten (Name, Marke, Beschreibung)
- articles – preisgestaltende Faktoren (Gebindepreis, Preis pro Liter, Verfügbarkeit)
- allergenes / details – normalisierte Detail-Tabellen
Damit sind Analysen möglich, die über Excel-Auswertungen hinausgehen – etwa das Finden von Preisausreißern innerhalb einer Marke:
-- Beispielanalyse: Durchschnittspreis pro Marke mit Abweichung
SELECT
    p.brandName,
    COUNT(a.id) as anzahl_artikel,
    ROUND(AVG(a.price), 2) as durchschnittspreis,
    MAX(a.price) as max_preis
FROM product p
JOIN articles a ON p.id = a.productId
GROUP BY p.brandName
HAVING COUNT(a.id) > 5
ORDER BY durchschnittspreis DESC;
Implementierung des Schemas (Auszug):
c.execute("""
    CREATE TABLE IF NOT EXISTS product (
        id INTEGER PRIMARY KEY,
        alcoholInfo TEXT,
        alphabeticSort INTEGER,
        backgroundColor TEXT,
        brandId INTEGER,
        brandName TEXT,
        brandWebShopUrl TEXT,
        categoryId INTEGER,
        colorProfileId INTEGER,
        descriptionText TEXT,
        ghsInfo TEXT,
        ...
    )
""")
conn.commit()
4. Datenextraktion
BeautifulSoup half zunächst, im DOM der Website die relevanten Kategorie-URLs zu finden. Die eigentliche Extraktion übernimmt scrape_data(value): Die Funktion baut aus der Kategorie die Endpunkt-URL, lädt das JSON und speichert es in einem Ordner mit Zeitstempel (Schrägstriche im Kategorienamen werden zu Bindestrichen).
Über den ThreadPoolExecutor aus concurrent.futures werden alle Kategorien der value_list parallel abgerufen – das verkürzt die Gesamtlaufzeit.
timestamp = int(time.time())
folder_path = f"data/{timestamp}"
os.makedirs(folder_path, exist_ok=True)

def scrape_data(value):
    url = f"https://www.flaschenpost.de/data/{value}/23"
    response = requests.get(url)
    data = response.json()
    value = value.replace("/", "-")
    file_path = os.path.join(folder_path, f"{value}.json")
    with open(file_path, "w", encoding="utf-8") as file:
        json.dump(data, file, indent=4)

with concurrent.futures.ThreadPoolExecutor() as executor:
    executor.map(scrape_data, value_list)
5. Produktbilder herunterladen
Für eine visuelle Darstellung im Dashboard werden die in der Datenbank verknüpften Produktbilder geladen – ebenfalls parallel und nur, wenn das Bild noch nicht lokal existiert:
import requests
import json
import time
import os
import concurrent.futures
import sqlite3
from datetime import datetime

conn = sqlite3.connect('main.db')
c = conn.cursor()
c.execute("SELECT id, image, imageArticleId FROM product;")
rows = c.fetchall()
conn.close()

# create folder if not exists images
if not os.path.exists('images'):
    os.makedirs('images')

# download images from database concurrently
def download_image(row):
    url = row[1]
    imageArticleId = row[2]
    # check if image already exists
    if os.path.exists(f'images/{imageArticleId}.png'):
        print(f'Image {imageArticleId} already exists')
        return
    else:
        r = requests.get(url)
        with open(f'images/{imageArticleId}.png', 'wb') as f:
            f.write(r.content)
        print(f'Image {imageArticleId} downloaded')
        return

# download images concurrently
with concurrent.futures.ThreadPoolExecutor() as executor:
    executor.map(download_image, rows)

print('All images downloaded')
6. Dashboard mit Flask
Eine schlanke Flask-App stellt eine Route (/) für GET- und POST-Anfragen bereit: Nutzer geben eine SQL-Abfrage ein, die Ergebnisse erscheinen samt Produktbild auf derselben Seite.
Die zentrale Abfrage berechnet den Rabatt je Artikel und filtert verfügbare Produkte mit dem Tag „Tagesangebot“ oder „TOP-ANGEBOT“ – absteigend nach Rabatt sortiert:
SELECT DISTINCT p.name,
                a.imageArticleId,
                a.id,
                a.product_id,
                a.price,
                a.crossedPrice,
                ROUND(((a.price - a.offerPrice) / a.price) * 100, 2) AS discountPercentage,
                a.offerPrice,
                a.pricePerUnit,
                a.offerPricePerUnit
FROM articles a
JOIN product p ON a.product_id = p.id
WHERE a.onTopOfferText IN ("Tagesangebot", "TOP-ANGEBOT")
AND a.isAvailable = 1
ORDER BY discountPercentage DESC
from flask import Flask, render_template, request
import sqlite3
app = Flask(__name__, static_folder="images")
DATABASE = 'main.db'
def query_database(query):
conn = sqlite3.connect(DATABASE)
cursor = conn.cursor()
cursor.execute(query)
data = cursor.fetchall()
conn.close()
return data, [description[0] for description in cursor.description]
@app.route('/', methods=['GET', 'POST'])
def index():
headers = []
rows = []
if request.method == 'POST':
user_query = request.form['query']
results, headers = query_database(user_query)
rows = results
return render_template('index.html', headers=headers, rows=rows)
if __name__ == '__main__':
app.run(debug=True)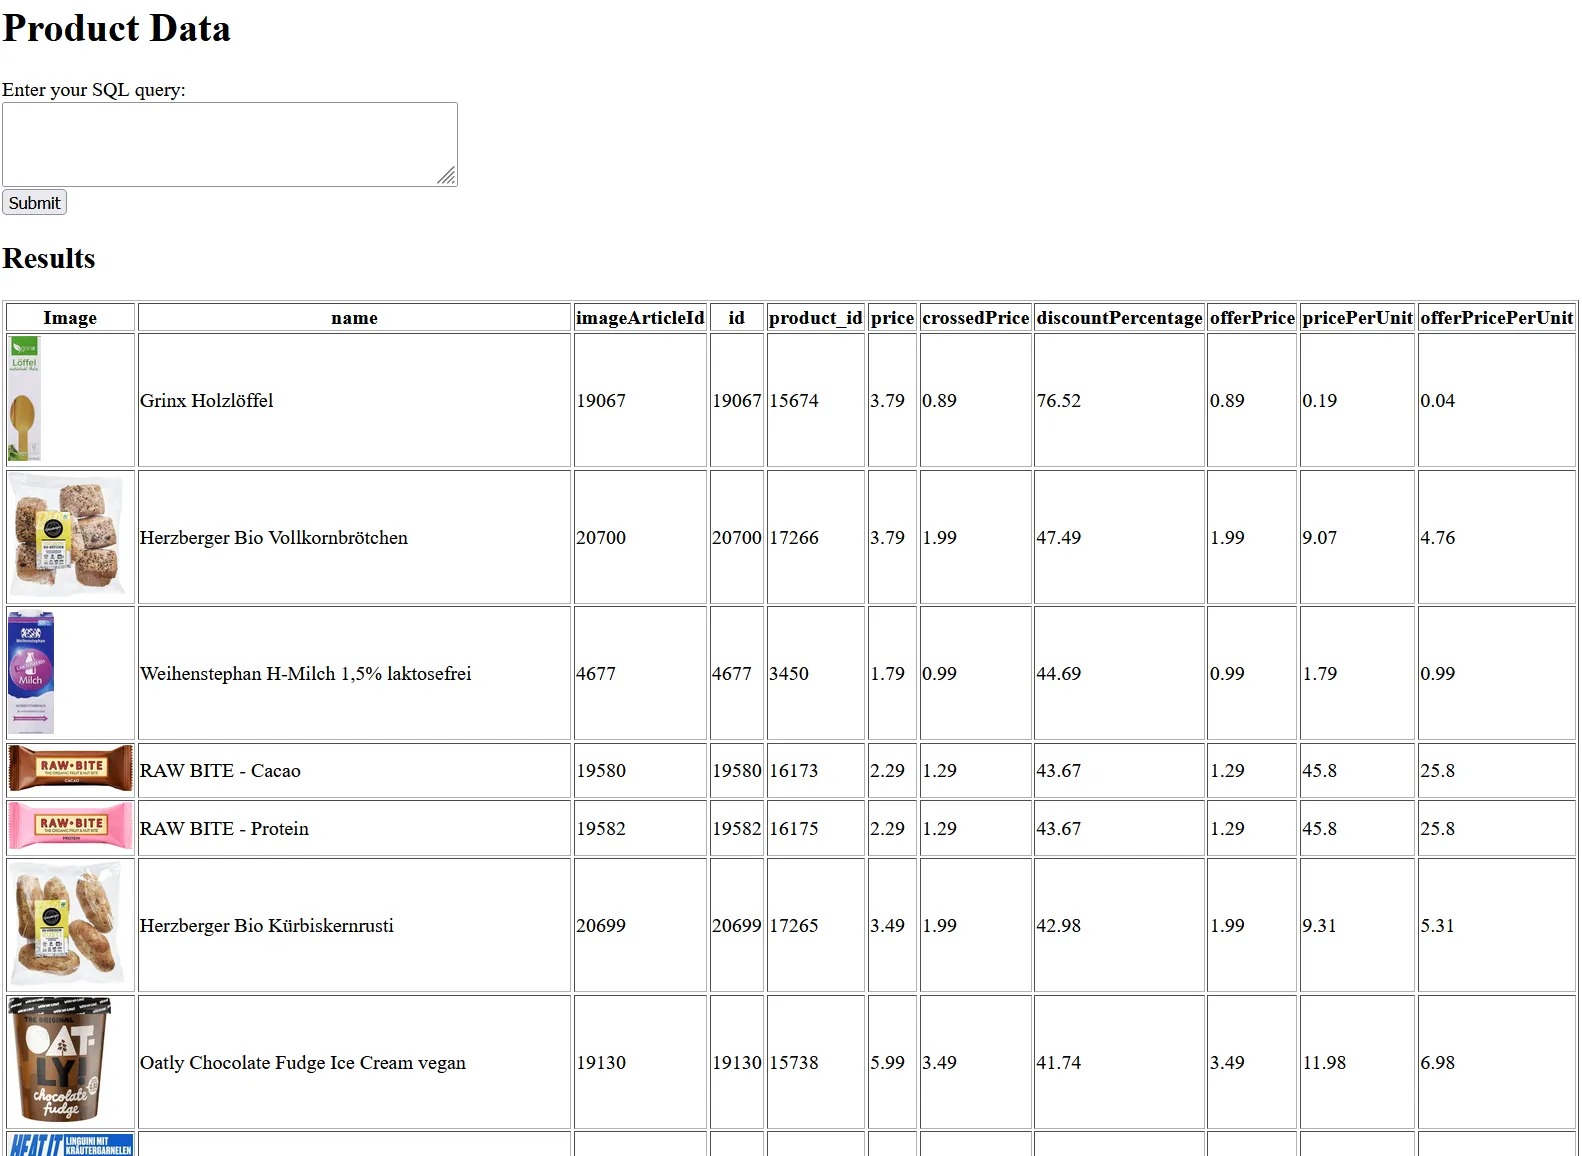
Werte aus Abb. 2 (discountPercentage), Momentaufnahme
Zusatzfunktion: Artikel in den Warenkorb legen
Über die Warenkorb-API des Webshops lassen sich Artikel auch programmatisch hinzufügen. Ein JSON-Objekt definiert Artikel-ID, Herkunft und Menge; per POST an https://www.flaschenpost.de/webshop-cart-api/api/v1/addCartPositions (mit den nötigen Cookies und Headern) antwortet der Server mit dem aktualisierten Warenkorb inklusive Artikeln und Gesamtpreis.
json_data = {
    'positions': [
        {
            'articleId': row[2],
            'articleOrigin': 1,
            'quantity': 1,
        },
    ],
    'cartVersion': 40,
}

response = requests.post(
    'https://www.flaschenpost.de/webshop-cart-api/api/v1/addCartPositions',
    cookies=cookies,
    headers=headers,
    json=json_data,
)
Mögliche Erweiterungen
- Preistracking & Preisalarme: Regelmäßige Erfassung macht Trends und Preisschwankungen sichtbar und ermöglicht Alarme bei Preisänderungen.
- Bestandsverfolgung: Benachrichtigung, wenn ein Produkt wieder verfügbar ist oder der Bestand knapp wird.
- Personalisierte Empfehlungen: Produktvorschläge auf Basis bisheriger Einkäufe.
- Abo-Einkauf: Eine Funktion zum Wiederholen eines Einkaufs fehlt im Shop – mit der Warenkorb-API lässt sich das automatisieren.
- LLM-Rezeptvorschläge: Ein LLM stellt aus den Datenbank-Artikeln ein Gericht zusammen, z.B. „Erstelle mir einen Warenkorb mit einem gesunden und günstigen Mittagessen“.