KI-Produktivitäts-Suite: Desktop-Workflow-Automatisierung
01 Herausforderung
Im Tagesgeschäft (Support, Content) kostet der Kontextwechsel Zeit: Text kopieren, ChatGPT öffnen, einfügen, warten, zurückkopieren – und sensible Daten landen in der Cloud.
02 Ansatz
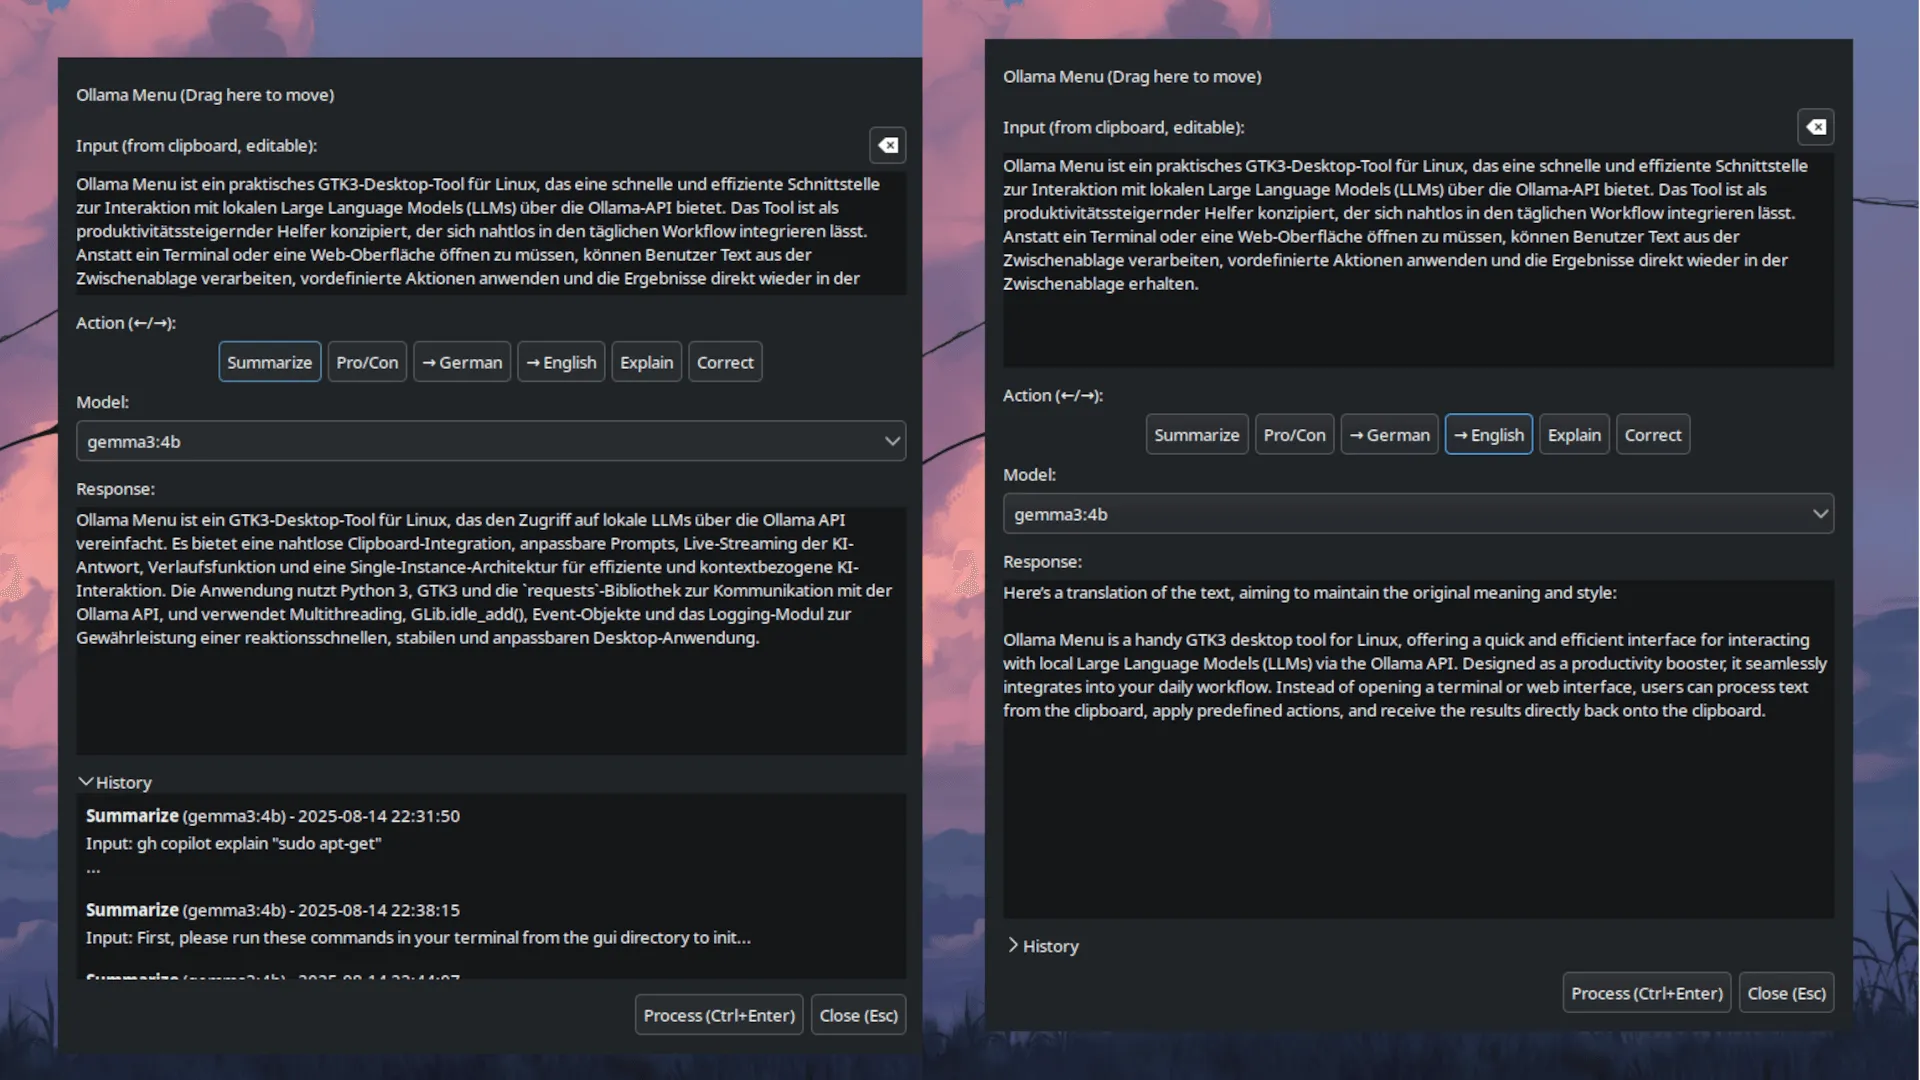
Ein natives GTK3-Tool startet mit dem Inhalt der Zwischenablage, bietet vordefinierte Aktionen und streamt die Antwort eines lokalen Ollama-Modells in Echtzeit.
03 Ergebnis
KI-Funktionen per Tastendruck direkt im Desktop-Workflow – ohne Copy-Paste-Umwege und ohne dass Firmendaten den Laptop verlassen.
Im operativen Tagesgeschäft eines E-Commerce Managers (z.B. Kundensupport, Content-Erstellung) geht viel Zeit durch Kontextwechsel verloren: Man kopiert Text, öffnet ChatGPT, fügt ein, wartet, kopiert zurück.
Ollama Menu ist eine „Productivity Suite“, die KI-Funktionen direkt in den Desktop-Workflow integriert. Sie eliminiert den „Copy-Paste-Wahnsinn“ und gibt Mitarbeitern mit einem einzigen Tastendruck Zugriff auf firmeneigene KI-Modelle.
- Standard-Aktionen
- 6
- Summarize · Pro/Con · Übersetzen · Explain · Correct
- Einträge im Verlauf
- 100
- Input, Output, Modell, Aktion
- Inferenz
- lokal
- alle Ollama-Modelle wählbar
- Instanz
- 1
- Single-Instance per PID-Datei
Business Value: Effizienzsteigerung
Vorher: Copy-Paste-Workflow
- Text kopieren
- ChatGPT im Browser öffnen
- Einfügen, Prompt tippen, warten
- Antwort zurückkopieren
- Daten verlassen das Unternehmen
Mit Ollama Menu
- Tool startet mit der Zwischenablage
- Aktion per Pfeiltaste wählen
- Ctrl+Enter – Antwort streamt live
- Ergebnis direkt weiterverwenden
- Lokales Modell, Daten bleiben auf dem Laptop
- Support-Beschleunigung: Ein Agent markiert eine Kunden-E-Mail und wählt „Antwort formulieren“ – der Entwurf ist sofort in der Zwischenablage.
- Content-Standardisierung: Texter nutzen vordefinierte Prompts (z.B. „SEO-Optimierung für Produktbeschreibung“) für konsistente Ergebnisse.
- Datenschutz: Da lokale Modelle (via Ollama) genutzt werden, verlassen keine sensiblen Firmendaten den Laptop des Mitarbeiters.
Hauptmerkmale
- Nahtlose Clipboard-Integration: Startet mit dem aktuellen Inhalt der Zwischenablage, der direkt bearbeitet werden kann.
- Anpassbare Aktionen: Eine externe
prompts.jsondefiniert Aktionen mit eigenen System-Prompts – beliebig erweiterbar. - Dynamische Modellauswahl: Erkennt automatisch alle lokal über Ollama verfügbaren Modelle und listet sie im Dropdown.
- Live-Streaming: Die Antwort erscheint in Echtzeit, während sie generiert wird – wichtig für die User Experience bei längeren Antworten.
- Verlauf: Speichert die letzten 100 Anfragen (Input, Output, Modell, Aktion) zum schnellen Wiederherstellen und Kopieren.
- Tastatursteuerung: Pfeiltasten zur Aktionswahl,
Ctrl+Enterzum Absenden,Esczum Schließen.
Architektur
Das Tool ist als natives GTK3-Interface entwickelt, um minimale Ressourcen zu verbrauchen und stabil im Hintergrund zu laufen.
- 01InputInhalt der Zwischenablage, editierbarClipboard
- 02Aktion & ModellSystem-Prompt aus prompts.json, Modell aus Ollamaprompts.json
- 03Hintergrund-ThreadAnfrage an die Ollama REST-API, alte Anfrage wird abgebrochenthreading
- 04StreamingUI-Updates sicher im Haupt-ThreadGLib.idle_add
- 05VerlaufErgebnis wird gespeichert und ist kopierbarhistory.json
Technische Highlights und Lösungsansätze
Reaktionsfähige Oberfläche durch Multithreading
Problem: Anfragen an die Ollama-API können mehrere Sekunden dauern. Im Haupt-Thread ausgeführt, würde die gesamte Oberfläche einfrieren.
Lösung: Jede Anfrage läuft in einem eigenen Hintergrund-Thread (threading.Thread), die GUI bleibt jederzeit reaktionsfähig. Um Komponenten wie das Antwort-Textfeld sicher aus dem Hintergrund zu aktualisieren, wird GLib.idle_add() verwendet: Alle UI-Updates laufen im Haupt-Thread, Race Conditions werden verhindert.
Robuste Prozessverwaltung
Problem: Ein Benutzer könnte versehentlich eine neue Anfrage starten, während eine alte noch läuft.
Lösung: Eine Abbruch-Logik mit threading.Event: Vor dem Start eines neuen Threads wird geprüft, ob bereits einer läuft – falls ja, erhält er ein Abbruchsignal. Das sorgt für vorhersehbares Verhalten und verhindert überlappende Anfragen. Das Live-Streaming gibt zudem sofortiges Feedback.
Saubere Architektur und Konfiguration
Problem: Hartcodierte Prompts und Einstellungen machen eine Anwendung unflexibel.
Lösung: Die Anwendung folgt dem XDG-Base-Directory-Standard: Konfiguration (prompts.json) liegt in ~/.config, Anwendungsdaten (history.json) in ~/.local/share. Code und Benutzerdaten sind getrennt, das Tool bleibt leicht anpassbar und wartbar.
Professionelles Anwendungs-Handling
Die Single-Instance-Sperre über eine PID-Datei (/tmp/ollama-menu-python.pid) verhindert, dass Benutzer versehentlich mehrere Fenster öffnen – das würde für Verwirrung und unnötigen Ressourcenverbrauch sorgen.
Strukturiertes Logging (logging-Modul) und sauberes Exception-Handling sorgen für Stabilität und erleichtern die Fehlersuche.