KPI-Optimierung & Kundensegmentierung
01 Herausforderung
Segmente aus der Datenanalyse (z.B. RFM) bleiben in Reports liegen – der Shop zeigt trotzdem allen Besuchern denselben Inhalt, auch wenn sie nicht eingeloggt sind.
02 Ansatz
Eine Personalisierungs-Engine zwischen Shop und Datenbank: Identity Resolution per Cookie und Login, Segment-Lookup in Redis und deterministische A/B-Zuweisung per Hash.
03 Ergebnis
Ein Blueprint, der jedem Segment in Echtzeit passenden Content ausspielt und jede Variante messbar macht – mit Consent-Fallback und Edge-Ausführung für niedrige Latenz.
In modernen digitalen Ökosystemen reicht statische Datenanalyse nicht mehr aus. Dieses Projekt demonstriert den Aufbau einer Echtzeit-Personalisierungs-Engine, die analytische Erkenntnisse (wie RFM-Segmentierung) direkt in handlungsrelevante User Experiences übersetzt. Ziel ist die Maximierung des Customer Lifetime Value (CLV) durch datengetriebene Individualisierung.
Die implementierte Architektur verknüpft Identity Resolution mit dynamischer Content-Ausspielung und validiert Optimierungsmaßnahmen durch statistisch belastbare A/B-Tests. Dies ermöglicht eine kontinuierliche Verbesserung der Key Performance Indicators (KPIs) basierend auf verifiziertem Nutzerverhalten.
- Segment-Strategien
- 3
- Retention · Churn · Onboarding
- A/B-Split
- 50/50
- deterministisch per SHA-256
- Tage
- 365
- Laufzeit der Guest-ID
- Ziel-Latenz
- < 50 ms
- mit Edge Functions
Strategie: Segment-Based Targeting
Die Überführung von abstrakten Kundendaten (z.B. aus einer RFM-Klassifizierung) in konkrete Business-Logik ist der Kern dieses Ansatzes:
- High-Value Retention: „Champions“ erhalten exklusive Angebote zur Stärkung der Markenbindung.
- Churn Prevention: „At Risk“-Kunden werden durch gezielte Reaktivierungskampagnen zurückgewonnen.
- Onboarding Optimization: Neukunden erhalten vertrauensbildende Inhalte zur Conversion-Steigerung.
Das System entscheidet in Echtzeit über die Ausspielung, um die Relevanz für den Nutzer zu maximieren.
Technische Architektur
Die Umsetzung erfolgt über eine Microservice-Architektur (z.B. mit Python/FastAPI), die zwischen dem Frontend (Shop) und der Datenbank sitzt.
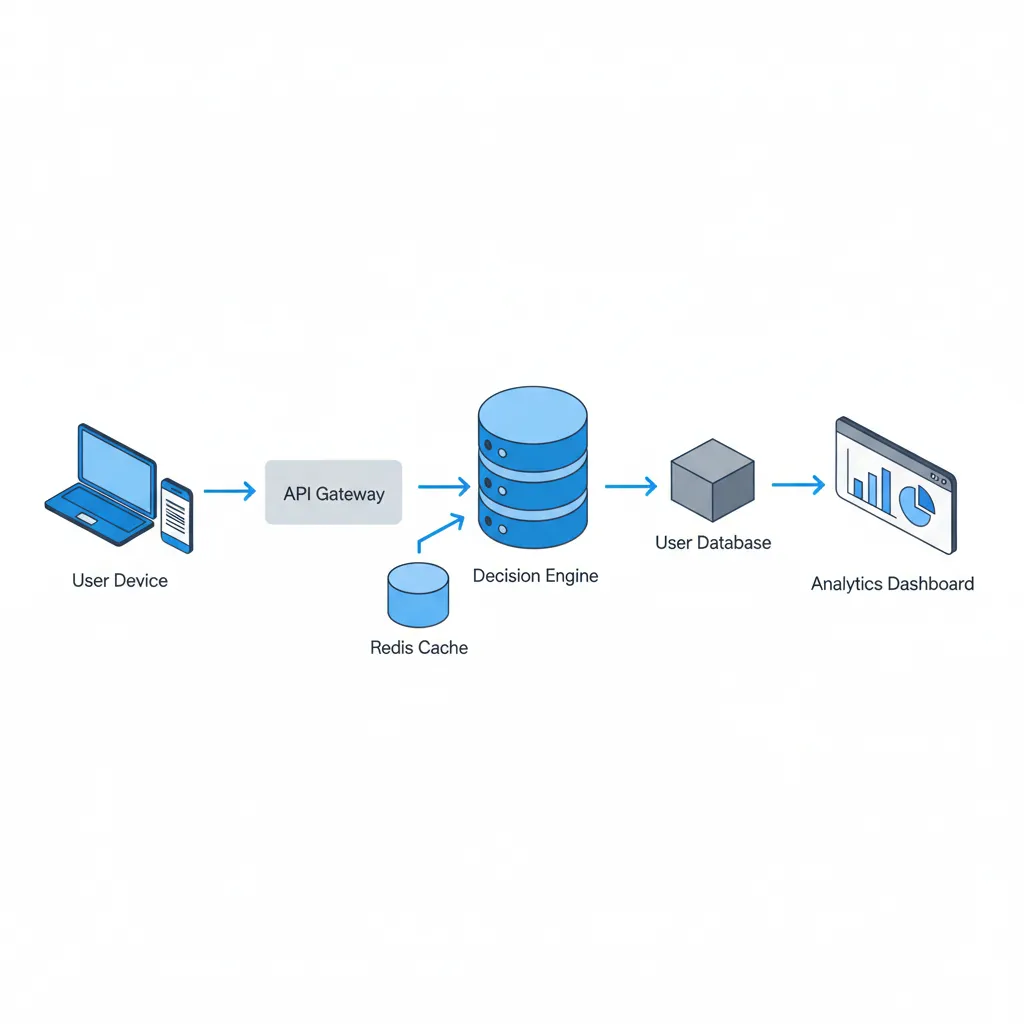
- 01BesuchShop lädt und fragt die Personalisierungs-API anFrontend
- 02IdentitätGuest-ID aus Cookie oder User-ID nach LoginCookie
- 03SegmentSchneller Lookup des KundensegmentsRedis
- 04VarianteDeterministische A/B-Zuweisung per HashSHA-256
- 05TrackingEvent mit Segment, Experiment und VarianteAnalytics
1. Identifikation & Tracking (Frontend)
Die größte Herausforderung: Wie erkennen wir Kunden, die nicht eingeloggt sind?
Hier greift das Konzept der Identity Resolution. Wir nutzen eine Kombination aus Cookies und Login-Daten:
- Anonymous ID (Gast): Beim ersten Besuch erhält jeder Nutzer eine zufällige UUID, die im Cookie gespeichert wird (z.B.
guest_123). - User ID (Eingeloggt): Sobald sich der Nutzer einloggt, verknüpfen wir die
guest_123mit seiner echtenuser_id_99. - Wiedererkennung: Kommt der Nutzer später wieder (ohne Login), erkennen wir ihn über das Cookie (
guest_123) und wissen im Backend: „Das ist eigentlichuser_id_99(ein Champion)“.
// Beispiel: Frontend-Logik zur Identifikation
function getIdentity() {
  let guestId = getCookie('guest_id');
  if (!guestId) {
    guestId = generateUUID(); // Erstelle neue ID für unbekannte Besucher
    setCookie('guest_id', guestId, 365); // Speichere für 1 Jahr
  }
  // Wenn User eingeloggt ist, nutzen wir die UserID, sonst die GuestID
  return window.currentUser ? window.currentUser.id : guestId;
}

// Request an die Personalization-API
async function fetchPersonalizedContent() {
  const id = getIdentity();
  const response = await fetch('https://api.myshop.com/personalize', {
    method: 'POST',
    body: JSON.stringify({ user_id: id }),
    headers: { 'Content-Type': 'application/json' }
  });

  const data = await response.json();
  renderComponent(data.variant);
}
2. Die Decision Engine (Backend)
Das Herzstück ist der Backend-Service. Er entscheidet in Millisekunden, welchen Inhalt der Nutzer sieht.
Schritt A: Segment abrufen Der Service prüft in einer schnellen Datenbank (z.B. Redis), in welchem Segment der User ist.
Schritt B: A/B-Test-Zuweisung Um zu prüfen, ob eine Maßnahme wirkt, führen wir A/B-Tests durch. Selbst innerhalb der „Champions“ wollen wir vielleicht testen, ob Bild A oder Bild B besser funktioniert.
Hier ein vereinfachtes Python-Beispiel für die Logik:
import hashlib

def get_user_variant(user_id, experiment_id):
    """
    Deterministische Zuweisung eines Users zu einer Variante (A oder B).
    Nutzt Hashing, damit der User bei jedem Besuch die gleiche Variante sieht.
    """
    hash_input = f"{user_id}-{experiment_id}".encode('utf-8')
    hash_val = int(hashlib.sha256(hash_input).hexdigest(), 16)

    # 50/50 Split
    return 'Variant_A' if hash_val % 2 == 0 else 'Variant_B'

def get_content_for_user(user_id):
    # 1. Segment laden (z.B. aus Redis/Datenbank)
    segment = database.get_user_segment(user_id) # z.B. "Champions"

    # 2. Logik basierend auf Segment
    if segment == "Champions":
        # A/B Test für Champions: "Early Access" vs. "VIP Event"
        variant = get_user_variant(user_id, "champion_experiment_v1")
        return {
            "component": "hero_banner",
            "variant": variant,
            "headline": "Exklusiv für dich: Die neue Kollektion" if variant == 'Variant_A' else "VIP-Einladung: Fashion Night"
        }

    elif segment == "At_Risk":
        return {
            "component": "popup_modal",
            "variant": "winback_discount",
            "discount_code": "WELCOMEBACK20"
        }

    else:
        # Fallback für unbekannte User / Standard-Segment
return {"component": "standard_hero"}Tracking & Analyse
Das Ausspielen verschiedener Varianten bringt nichts, wenn wir den Erfolg nicht messen. Jede Interaktion muss getrackt werden.
Wir senden Events an unser Analytics-Tool (z.B. PostHog, Google Analytics 4 oder ein eigenes Data Warehouse):
- Event:
view_item - Properties:
segment: “Champions” ·experiment_id: “champion_experiment_v1” ·variant: “Variant_A”
Wichtige Überlegungen: Datenschutz & Performance
Technisch ist vieles möglich, aber in der Praxis gibt es zwei kritische Faktoren, die oft übersehen werden.
Datenschutz (DSGVO)
Bevor wir IDs verknüpfen oder personalisierte Inhalte anzeigen, benötigen wir den Consent des Nutzers. Ohne Zustimmung im Cookie-Banner darf kein Tracking stattfinden.
Ohne Consent
- Keine Guest-ID, keine Verknüpfung mit der User-ID
- Kein Event-Tracking
- Fallback: Standard-Variante für alle
Mit Consent
- Wiedererkennung per Cookie und Login
- Segment-spezifische Variante inkl. A/B-Test
- Events mit Segment, Experiment und Variante
Performance (Latenz)
Der API-Call zur Personalisierung passiert oft beim Laden der Seite. Wenn die API 500 ms braucht, wartet der Nutzer vor einem weißen Bildschirm.
Fazit
Durch die Verknüpfung von Data Science (RFM-Analyse) und Software Engineering (API & A/B-Testing) schaffen wir ein dynamisches Einkaufserlebnis. Wir raten nicht mehr, was der Kunde will – wir wissen es aus den Daten und validieren unsere Hypothesen durch Tests.
Dies ist der Blueprint für modernes, datengetriebenes E-Commerce-Marketing.
👉 Grundlage: Die hier genutzten Segmente stammen aus meinem Projekt Kundensegmentierung via RFM-Analyse.