Strategische Agenten-Navigation mit Deep RL
01 Herausforderung
Ein Agent soll in einer geschlossenen Arena Ziele einsammeln, einem verfolgenden Gegner ausweichen und tödliche Wände meiden – ohne starre, regelbasierte Logik.
02 Ansatz
Unity ML-Agents mit PPO: 360°-Ray-Perception plus Vektor-Beobachtungen, eine iterativ gestaltete Reward Function und Training über 2 Millionen Simulationsschritte.
03 Ergebnis
Der durchschnittliche Reward stieg von -9.0 auf über 70.0 (ca. 34 Pellets pro Leben); der Agent setzt seinen Dash taktisch ein und „kitet“ den Gegner.
Dieses Projekt demonstriert das Potenzial von Deep Reinforcement Learning zur Lösung komplexer logistischer Herausforderungen in dynamischen Umgebungen. Im Fokus steht die Entwicklung autonomer Agenten, die lernen, effizient Ziele zu erreichen, Ressourcen zu priorisieren und Gefahren in Echtzeit zu navigieren – ein Szenario, das direkt auf autonome Lagerlogistik oder Navigationssysteme übertragbar ist.
Anstatt auf starren, regelbasierten Algorithmen zu basieren, nutzt dieses System eine belohnungsbasierte Lernarchitektur. Durch Millionen von Simulationsschritten optimiert der Agent selbstständig seine Strategien für maximale Effizienz und Risikominimierung.
- Trainingsschritte
- 2 Mio.
- PPO in Unity ML-Agents
- Ø Reward
- -9 → 70+
- von Phase 1 bis Phase 3
- Pellets pro Leben
- ~34
- im trainierten Zustand
- Wahrnehmung
- 360°
- Ray Perception Sensors 3D
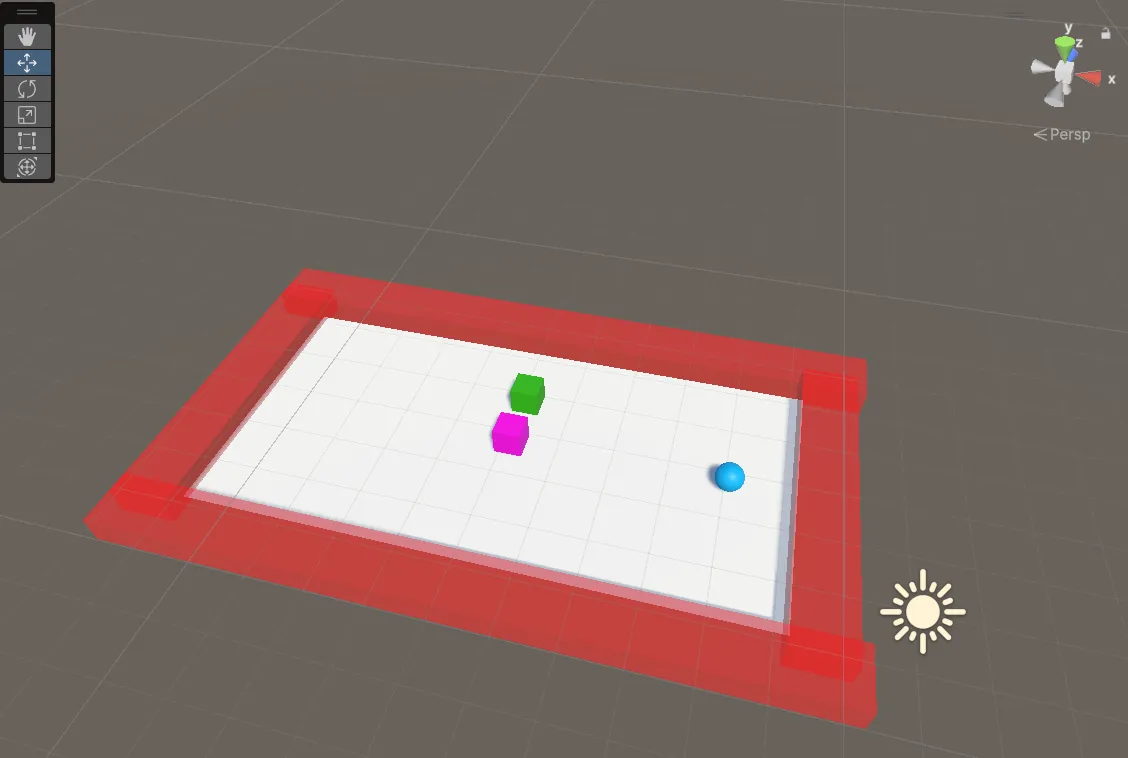 Arena mit Agent (pink), Zombie (grün) und Pellet (blau)
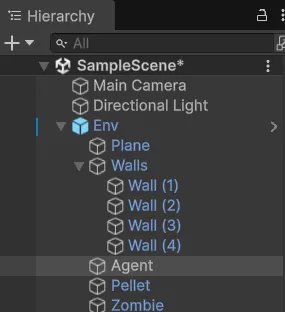 Szenen-Hierarchie: Plane, 4 Wände, Agent, Pellet, Zombie
Das Szenario: Überleben um jeden Preis
Die Simulation besteht aus drei Hauptakteuren in einer geschlossenen Arena:
- Der Agent (Pink): Der KI-Protagonist. Er kann sich bewegen und hat eine spezielle „Dash“-Fähigkeit (schneller Sprint) mit Cooldown.
- Der Zombie (Grün): Ein einfacher Bot, der den Agenten ständig verfolgt. Eine Berührung beendet die Episode sofort (-10 Punkte).
- Das Pellet (Blau): Das Zielobjekt. Einsammeln bringt +5 Punkte und lässt das Pellet an einer neuen zufälligen Position respawnen.
Zusätzlich sind die Wände tödlich. Der Agent musste also lernen, nicht nur dem Zombie auszuweichen, sondern sich auch nicht in die Enge treiben zu lassen.
Der technische Ansatz
Das Projekt basiert auf Unity und dem ML-Agents Toolkit. Als Trainingsalgorithmus kam PPO (Proximal Policy Optimization) zum Einsatz, ein Standardverfahren für kontinuierliche Kontrollprobleme.
- 01WahrnehmungStrahlen erkennen Wand, Pellet, Zombie + DistanzRay Sensors
- 02BeobachtungPosition, Geschwindigkeit, Ziel, Dash-StatusVektor-Obs
- 03EntscheidungNeuronales Netz wählt Bewegung und DashPPO-Policy
- 04AktionPhysik-basierte Bewegung im RigidbodyC#
- 05BelohnungReward/Strafe fließt ins Training zurückReward
1. Die Wahrnehmung (Sensoren)
Damit der Agent seine Umwelt „sehen“ kann, habe ich ihn mit Ray Perception Sensors 3D ausgestattet. Man kann sich das wie ein LIDAR-System vorstellen: Der Agent sendet unsichtbare Strahlen in einem 360-Grad-Radius aus. Diese liefern ihm Informationen darüber, ob sich in einer Richtung eine Wand, ein Pellet oder der Zombie befindet und wie weit diese entfernt sind.
Zusätzlich erhält das neuronale Netz numerische Daten (Vektor-Beobachtungen):
- die eigene Position und Geschwindigkeit,
- die relative Position zum Ziel,
- den Status des „Dash“-Cooldowns (bereit oder nicht).
2. Das Belohnungssystem (Reward Function)
Der kritischste Teil beim Reinforcement Learning ist das Design der Belohnungen. Das finale System:
| Ereignis | Reward | Absicht |
|---|---|---|
| Existenz | +0.001 pro Schritt | Belohnt reines Überleben |
| Pellet eingesammelt | +5.0 | Das Hauptziel |
| Notfall-Dash | +0.2 | Dash, wenn der Zombie sehr nah ist |
| Tod (Wand oder Zombie) | -10.0 | Katastrophales Versagen, Episode endet |
3. Das Training
Das Training lief über 2 Millionen Schritte. Der Lernfortschritt lässt sich in drei Phasen gliedern:
| Phase | Schritte | Ø Reward | Verhalten |
|---|---|---|---|
| 1 | 0 – 200k | -9.0 | Bewegt sich kaum oder rennt zufällig gegen Wände |
| 2 | ~500k | +17.0 | Versteht, dass Pellets gut sind, wird aber oft gefangen |
| 3 | 1.5M+ | über 70.0 | Nutzt den Dash taktisch und „kitet“ den Zombie effizient |
In Phase 3 erreicht der Agent eine „Superhuman“-Performance: Er weicht dem Zombie im letzten Moment per Dash aus und sammelt dabei im Schnitt ca. 34 Pellets pro Leben, ohne zu sterben.
Das Ergebnis
Das folgende Video zeigt den fertig trainierten Agenten (mit dem ONNX-Modell) in Aktion. Man beachte, wie er wartet, bis der Zombie nahe ist, um dann den Dash zu nutzen und durch die Lücke zu entkommen.
Verwendete Technologien
- Engine: Unity 2022 LTS
- ML-Framework: Unity ML-Agents (PyTorch Backend)
- Algorithmus: PPO (Proximal Policy Optimization)
- Sprache: C# (für die Spiel-Logik und Agenten-Steuerung)
- Inferenz: Barracuda / ONNX Runtime
Code-Einblick
Hier ein Auszug aus der AgentController.cs, der zeigt, wie der Agent Entscheidungen (Aktionen) in Bewegung umsetzt und Belohnungen verteilt:
public override void OnActionReceived(ActionBuffers actions)
{
    // 1. Dash-Logik (Diskrete Aktion)
    int dashAction = actions.DiscreteActions[0];
    if (dashAction == 1 && m_DashCooldownTimer <= 0)
    {
        m_IsDashing = true;
        // Belohnung für taktischen Dash in Gefahrensituationen
        if (zombie != null && Vector3.Distance(transform.localPosition, zombie.localPosition) < 2.5f)
        {
            AddReward(0.2f);
        }
    }

    // 2. Bewegung (Kontinuierliche Aktionen)
    float moveX = actions.ContinuousActions[0];
    float moveZ = actions.ContinuousActions[1];

    // Physik-basierte Bewegung
    if (m_Rb != null)
    {
        Vector3 velocity = new Vector3(moveX * currentSpeed, 0, moveZ * currentSpeed);
        m_Rb.linearVelocity = velocity;
    }

    // 3. Kollisions-Handling (Bestrafung)
    // Wird in OnCollisionEnter verarbeitet:
    // Wand -> AddReward(-10f); EndEpisode();
    // Zombie -> AddReward(-10f); EndEpisode();
}
Learnings
- Reward Design ist der Hebel: Kleine Änderungen an der Belohnungsstruktur (Wandstrafe -1 → -10) verändern das gelernte Verhalten grundlegend.
- Gezielte Anreize für Taktik: Der kleine Bonus für den Notfall-Dash (+0.2) lenkt den Agenten dahin, seine Spezialfähigkeit im richtigen Moment einzusetzen.
- Übertragbarkeit: Die Kombination aus Sensorik, Zielpriorisierung und Gefahrenvermeidung ist direkt auf autonome Lagerlogistik oder Navigationssysteme übertragbar.